Open Source și Lab

Publicăm modele deschise — și contribuim upstream.

Fabrica rulează pe open source. Cuantizăm și reîmpachetăm modele deschise ca să ruleze bine pe hardware local, publicăm build-urile cu profiluri de servire măsurate și contribuim upstream la proiectele open-source pe care este construită fabrica noastră.

Modele deschise

Hugging Face

Build-uri cuantizate ale unor modele deschise pentru Apple Silicon (MLX și mflux), fiecare cu un profil de servire măsurat — de exemplu un model mixture-of-experts cu 125 de miliarde de parametri care rulează pe un singur Mac cu aproximativ 40 GB de memorie.

Modele pe Hugging Face

Comunitate

OpenClaw

Agenții noștri rulează pe OpenClaw, o platformă open-source pentru agenți. Raportăm și reproducem probleme upstream și propunem funcționalități — unul dintre rapoartele noastre de bug a dus la o corecție a unui maintainer, integrată (merged) aproximativ două zile mai târziu.

Novaeon pe GitHub

Seturi de date și evaluare

Seturi de date și evaluare

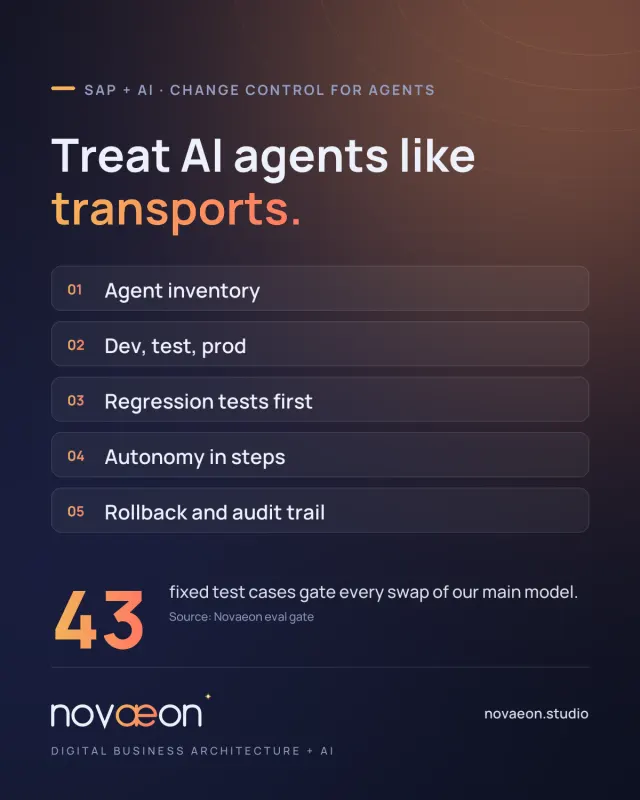
Ca serviciu: date de antrenare de domeniu și sintetice, curarea datelor și filtrare de calitate, seturi de evaluare și porți de regresie, fine-tuning LoRA pe modele deschise. Astăzi construim și folosim propriile seturi de evaluare — o poartă de regresie cu 43 de cazuri și un benchmark de rutare cu 60 de sarcini.

Mereu la zi cu tehnologia de vârf.

Continuăm să învățăm de la sursă. Acum parcurgem cursul CME295 de la Stanford, „Transformers & Large Language Models” (toamna 2026), și cursurile Hugging Face — iar fiecare model nou este testat pe benchmarkurile noastre înainte să ajungă la un client.
Studiu de caz

Novaeon Agent Factory

Propria noastră companie rulează pe fabrică. Înainte să construim agenți pentru clienți, îi operăm noi înșine — cu aceleași controale de calitate și de release pe care le implementăm la clienți.

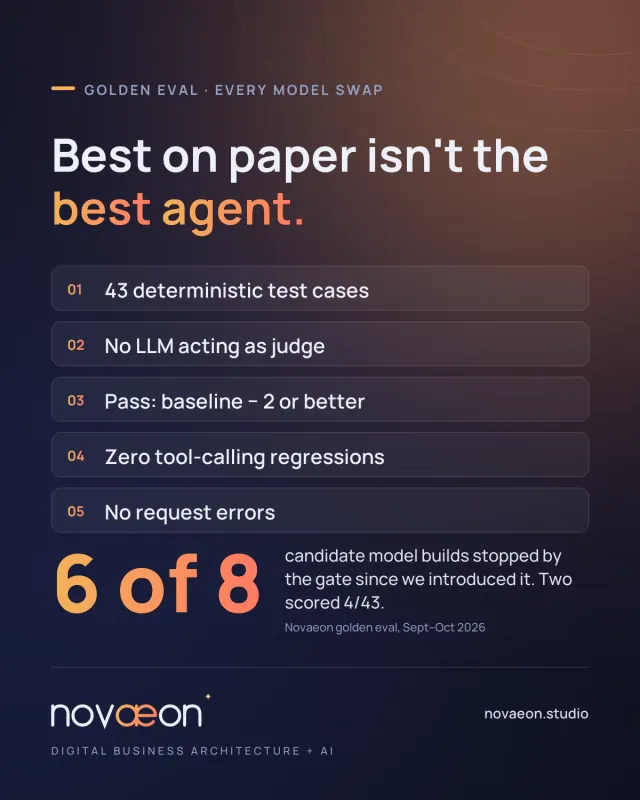
  • 43cazuri deterministe în poartă, per schimbare de model
  • 2 / 8modele candidate au trecut de poartă
  • 95%agent executant corect, benchmark de rutare cu 60 de sarcini
  • 90%nivel de model corect, același benchmark

Problema

O echipă de agenți care scrie, cercetează, publică și operează în fiecare zi, pe un mix de modele locale și cloud. Modelul principal s-a schimbat de aproximativ zece ori în trei săptămâni — fără un test fix înainte ca un model nou să intre în producție.

Abordarea

  • Un agent coordonator deleagă către agenți specializați (studio, operațiuni); cinci sau mai multe sarcini independente sunt distribuite pe linii paralele de lucru, care returnează rezultate structurate, cu dovezi citate.
  • Un router ia trei decizii per sarcină — cine o preia, ce nivel de model, raționament activat sau nu — cu doi evaluatori independenți; orice dubiu escaladează către modelul mai puternic.
  • O poartă de regresie pentru fiecare schimbare de model: 43 de cazuri de test deterministe, fără LLM ca evaluator. Trecut = scor de cel puțin baseline minus 2, zero regresii la apelarea uneltelor, zero erori de cerere. Fiecare schimbare produce acum și un dosar de release, înscris într-un jurnal de audit înlănțuit prin hash-uri.
  • Tot conținutul public este verificat față de surse și revizuit de un al doilea model, diferit, înainte să apară online.

Rezultatul

  • Schimbările de model au devenit release-uri: din 8 build-uri candidate, 2 au trecut de poartă și 6 au fost oprite înainte de producție.
  • Un model aflat în test a încercat să anunțe un reboot de server pentru care nu avea nicio unealtă — a ieșit la iveală în poartă, nu în producție.
  • Rutarea pe benchmarkul nostru de 60 de sarcini: 95% agent executant corect, 90% nivel de model corect; o decizie de rutare durează aproximativ 1,5 s pe hardware local.

Benchmarkuri proprii, octombrie 2026. Benchmarkul de rutare folosește 60 de cereri realiste cu etichete de referință fixe (măsurat înainte de adăugarea cazurilor de operare).

Primul dumneavoastră agent în producție — ca la carte.

Spuneți-ne despre proces, stack și constrângeri. Venim pregătiți la prima discuție.