Open Source & Lab

Wir veröffentlichen offene Modelle — und arbeiten upstream mit.

Die Agent Factory läuft auf Open Source. Wir quantisieren offene Modelle und verpacken sie neu, damit sie auf lokaler Hardware gut laufen, veröffentlichen die Builds mit gemessenen Serving-Profilen und arbeiten upstream an den Open-Source-Projekten mit, auf denen unsere Factory aufbaut.

Offene Modelle

Hugging Face

Quantisierte Builds offener Modelle für Apple Silicon (MLX und mflux), jeweils mit gemessenem Serving-Profil — zum Beispiel ein Mixture-of-Experts-Modell mit 125 Milliarden Parametern, das auf einem einzelnen Mac mit rund 40 GB Arbeitsspeicher läuft.

Modelle auf Hugging Face

Datensätze & Evaluierung

Datensätze & Evaluierung

Als Leistung: domänenspezifische und synthetische Trainingsdaten, Kuratierung und Qualitätsfilterung, Evaluierungssets und Regressions-Gates, LoRA-Fine-Tuning offener Modelle. Heute bauen und nutzen wir eigene Evaluierungssets — ein Regressions-Gate mit 43 Fällen und einen Routing-Benchmark mit 60 Aufgaben.

Immer am Puls der Entwicklung.

Wir bilden uns direkt an der Quelle weiter. Derzeit arbeiten wir den Stanford-Kurs CME295 „Transformers & Large Language Models“ (Herbst 2026) und die Hugging-Face-Kurse durch — und jedes neue Modell wird auf unseren eigenen Benchmarks getestet, bevor es einen Kunden erreicht.
Fallstudie

Die Novaeon Agent Factory

Unser eigenes Unternehmen läuft auf der Agent Factory. Bevor wir Agenten für Kunden bauen, betreiben wir sie selbst — mit denselben Qualitäts- und Release-Kontrollen, die wir bei Kunden umsetzen.

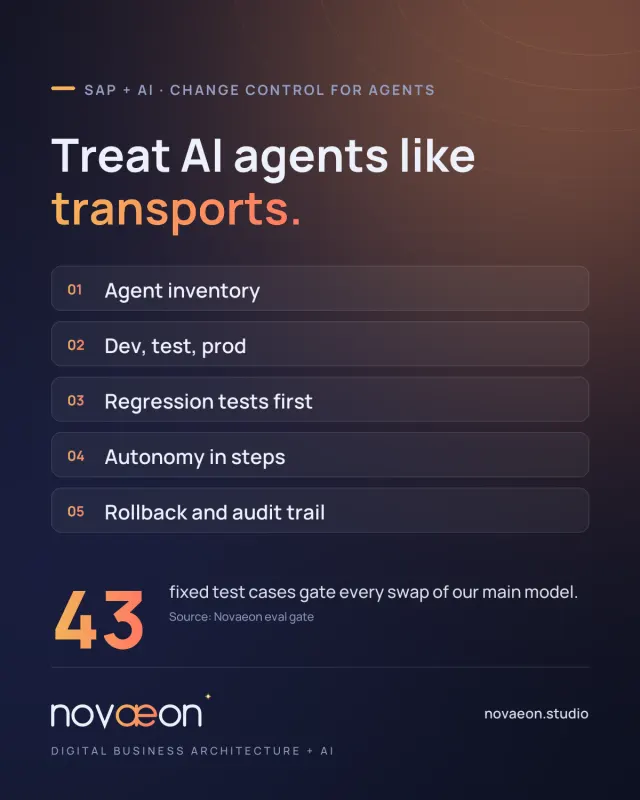
  • 43deterministische Gate-Fälle pro Modellwechsel
  • 2 / 8Kandidatenmodelle haben das Gate bestanden
  • 95%korrekter Handler, Routing-Benchmark mit 60 Aufgaben
  • 90%korrekte Modellklasse, gleicher Benchmark

Problem

Ein Team aus Agenten, das täglich schreibt, recherchiert, veröffentlicht und den Betrieb übernimmt — auf einer Mischung aus lokalen und Cloud-Modellen. Das Hauptmodell wechselte in drei Wochen etwa zehnmal — ohne festen Test, bevor ein neues Modell live ging.

Vorgehen

  • Ein Koordinator-Agent delegiert an spezialisierte Agenten (Studio, Betrieb); fünf oder mehr unabhängige Arbeitspakete werden auf parallele Worker-Lanes verteilt, die strukturierte Ergebnisse mit zitierten Belegen zurückliefern.
  • Ein Router trifft pro Aufgabe drei Entscheidungen — wer sie bearbeitet, welche Modellklasse, Reasoning an oder aus — mit zwei unabhängigen Bewertern; im Zweifel geht die Aufgabe an das stärkere Modell.
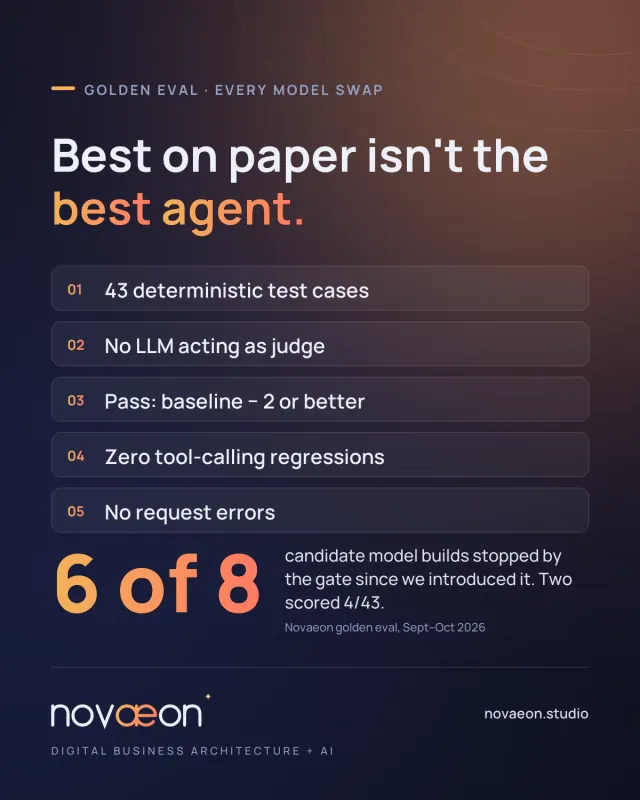
  • Ein Regressions-Gate für jeden Modellwechsel: 43 deterministische Testfälle, kein LLM als Bewerter. Bestanden = Score mindestens Baseline minus 2, null Regressionen beim Tool-Calling, null Request-Fehler. Jeder Wechsel erzeugt jetzt zusätzlich eine Release-Akte, eingetragen in ein per Hashwert verkettetes Audit-Protokoll.
  • Alle öffentlichen Inhalte werden anhand von Quellen geprüft und von einem zweiten, anderen Modell kontrolliert, bevor sie live gehen.

Ergebnis

  • Modellwechsel wurden zu Releases: Von 8 Kandidaten-Builds bestanden 2 das Gate, 6 wurden vor der Produktion gestoppt.
  • Ein getestetes Modell versuchte, einen Server-Neustart anzukündigen, für den es kein Tool hatte — es fiel im Gate auf, nicht in Produktion.
  • Routing in unserem Benchmark mit 60 Aufgaben: 95 % korrekter Handler, 90 % korrekte Modellklasse; eine Routing-Entscheidung dauert auf lokaler Hardware etwa 1,5 s.

Eigene Benchmarks, Oktober 2026. Der Routing-Benchmark nutzt 60 realistische Anfragen mit festen Referenz-Labels (gemessen, bevor Betriebsfälle hinzukamen).

Bringen Sie Ihren ersten Agenten in Produktion — und zwar richtig.

Erzählen Sie uns von Prozess, Stack und Rahmenbedingungen. Wir kommen vorbereitet ins erste Gespräch.