Código abierto y Lab

Publicamos modelos abiertos — y trabajamos upstream.

La fábrica funciona con código abierto. Cuantizamos y reempaquetamos modelos abiertos para que funcionen bien en hardware local, publicamos las versiones con perfiles de servicio medidos y trabajamos upstream en los proyectos de código abierto sobre los que está construida nuestra fábrica.

Modelos abiertos

Hugging Face

Versiones cuantizadas de modelos abiertos para Apple Silicon (MLX y mflux), cada una con un perfil de servicio medido — por ejemplo, un modelo mixture-of-experts de 125.000 millones de parámetros que funciona en un solo Mac con unos 40 GB de memoria.

Modelos en Hugging Face

Comunidad

OpenClaw

Nuestros agentes funcionan sobre OpenClaw, una plataforma de agentes de código abierto. Reportamos y reproducimos incidencias upstream y proponemos funcionalidades: uno de nuestros informes de error dio lugar a una corrección de un mantenedor del proyecto, integrada unos dos días después.

Novaeon en GitHub

En el laboratorio

Dataset: control de release de agentes

Un dataset abierto de solicitudes de cambio sintéticas para agentes, etiquetadas con clase de riesgo y controles de release.

Modelo con fine-tuning

Un pequeño adaptador LoRA sobre Qwen3-4B que estima el riesgo de un cambio de agente y los controles de release que requiere.

Datasets y evaluación

Datasets y evaluación

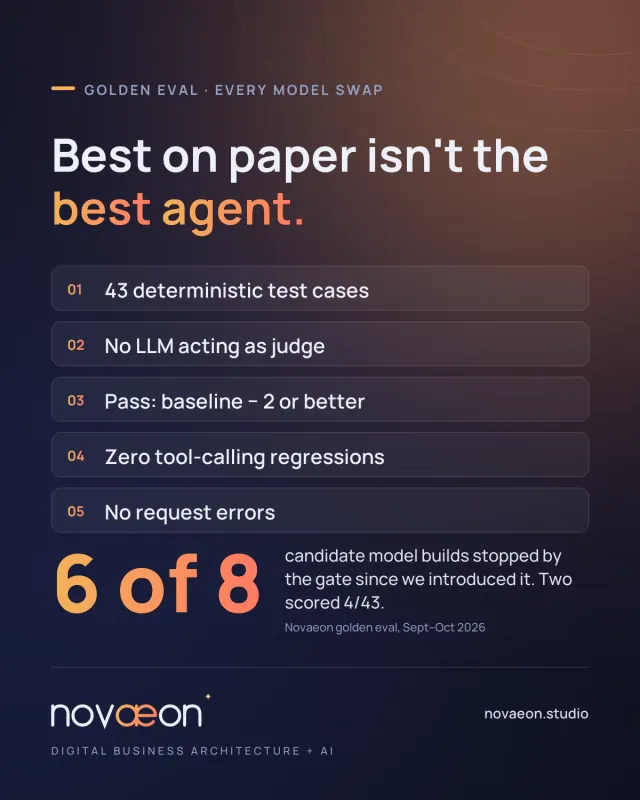
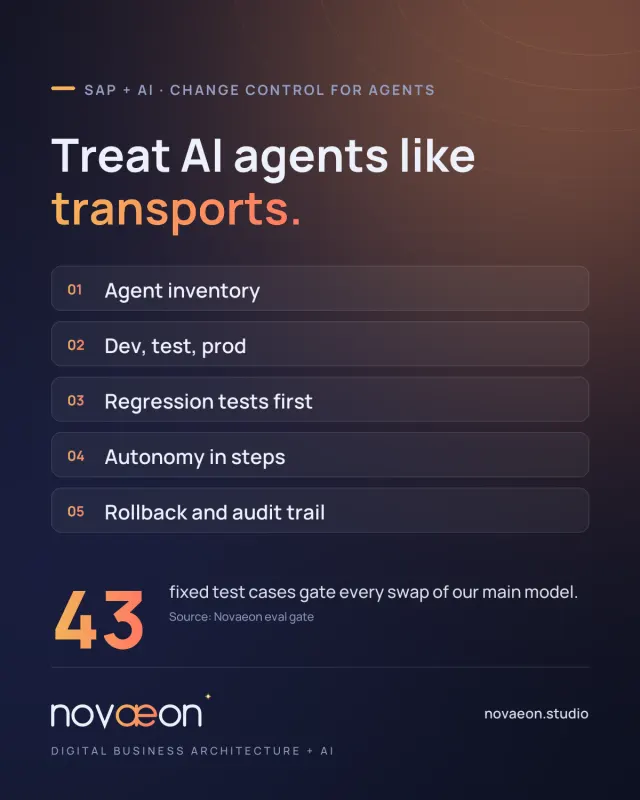
Como servicio: datos de entrenamiento sintéticos y específicos de dominio, curación y filtrado de calidad, conjuntos de evaluación y controles de regresión, fine-tuning de modelos abiertos con LoRA. Hoy construimos y usamos nuestros propios conjuntos de evaluación: un control de regresión de 43 casos y un benchmark de enrutamiento de 60 tareas.

Siempre a la vanguardia.

Seguimos aprendiendo directamente de la fuente. Ahora mismo estamos siguiendo el curso CME295 de Stanford, «Transformers & Large Language Models» (otoño de 2026), y los cursos de Hugging Face — y cada modelo nuevo se prueba con nuestros propios benchmarks antes de llegar a un cliente.
Caso de estudio

La Novaeon Agent Factory

Nuestra propia empresa funciona con la fábrica. Antes de construir agentes para clientes, los operamos nosotros — con los mismos controles de calidad y de release que implantamos en nuestros clientes.

  • 43casos de control deterministas por cambio de modelo
  • 2 / 8modelos candidatos superaron el control
  • 95%gestor correcto, benchmark de enrutamiento de 60 tareas
  • 90%nivel de modelo correcto, mismo benchmark

Problema

Un equipo de agentes que escribe, investiga, publica y opera a diario, con una combinación de modelos locales y en la nube. El modelo principal cambió unas diez veces en tres semanas — sin ninguna prueba fija antes de que un nuevo modelo entrara en producción.

Enfoque

  • Un agente coordinador delega en agentes especialistas (estudio, operaciones); cinco o más trabajos independientes se reparten en líneas de trabajo paralelas que devuelven resultados estructurados con evidencia citada.
  • Un router toma tres decisiones por tarea — quién la gestiona, qué nivel de modelo, razonamiento activado o no — con dos jueces independientes; ante cualquier duda, escala al modelo más potente.
  • Un control de regresión para cada cambio de modelo: 43 casos de prueba deterministas, sin LLM como juez. Aprobado = puntuación de al menos la línea base menos 2, cero regresiones en tool calling, cero errores de petición. Cada cambio genera ahora también un expediente de release, anotado en un registro de auditoría encadenado por hashes.
  • Todo lo público se verifica contra las fuentes y lo revisa un segundo modelo, distinto, antes de publicarse.

Resultado

  • Los cambios de modelo se convirtieron en releases: de 8 versiones candidatas, 2 superaron el control y 6 se detuvieron antes de producción.
  • Un modelo en prueba intentó anunciar un reinicio del servidor para el que no tenía herramienta: salió a la luz en el control, no en producción.
  • Enrutamiento en nuestro benchmark de 60 tareas: 95% de gestor correcto, 90% de nivel de modelo correcto; una decisión de enrutamiento tarda unos 1,5 s en hardware local.

Benchmarks propios, octubre de 2026. El benchmark de enrutamiento usa 60 peticiones realistas con etiquetas de referencia fijas (medido antes de añadir los casos de operaciones).

Lleve su primer agente a producción. Y hágalo bien.

Cuéntenos el proceso, el entorno y las restricciones. Llegamos preparados a la primera llamada.