开源与实验室

我们发布开放模型,也在上游参与开源。

这座工厂运行在开源之上。我们量化并重新打包开放模型,让它们在本地硬件上高效运行;发布这些构建版本并附上实测的服务配置;同时在工厂所依赖的开源项目上游积极参与。

开放模型

Hugging Face

面向 Apple Silicon(MLX 与 mflux)的开放模型量化版本,每个都附有实测的服务配置。例如一个 1250 亿参数的混合专家模型,可在一台约 40 GB 内存的 Mac 上运行。

Hugging Face 上的模型

实验室进行中

数据集:智能体发布关口

一套开放的面向智能体的合成变更请求数据集,标注了风险等级与所需发布关口。

微调模型

一个基于 Qwen3-4B 的小型 LoRA 适配器,用于评估智能体变更的风险以及所需的发布关口。

数据集与评测

数据集与评测

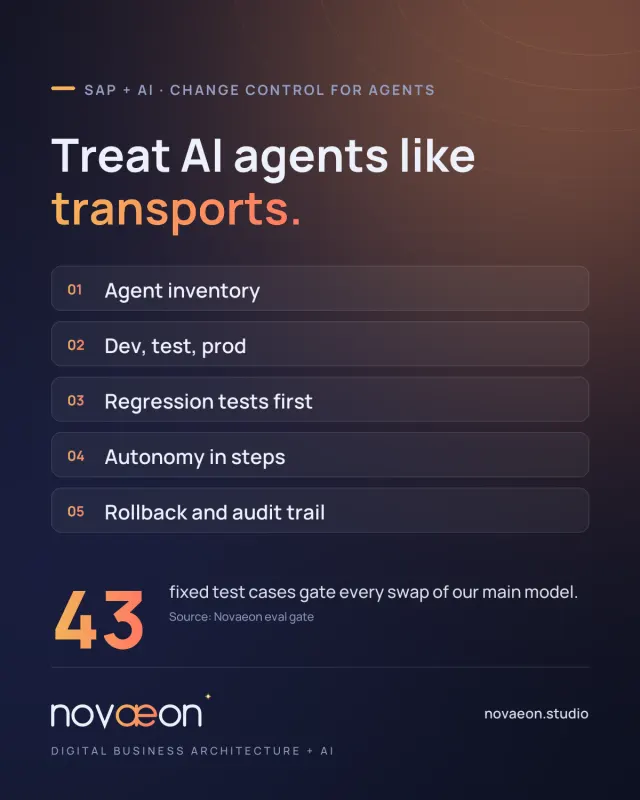
以服务形式提供:领域数据与合成训练数据、数据整理与质量过滤、评测集与回归关口、开放模型的 LoRA 微调。目前,我们构建并使用自己的评测集:一套 43 个用例的回归关口,以及一套 60 项任务的路由基准。

始终站在前沿。

我们从源头持续学习。目前我们正在学习斯坦福大学的 CME295 “Transformers & Large Language Models”(2026 年秋季)课程以及 Hugging Face 的课程;每个新模型在交付给客户之前,都会先在我们自己的基准上测试。
案例研究

Novaeon 智能体工厂

我们公司自身就运行在这座工厂上。在为客户构建智能体之前,我们先自己运营它们,使用的正是我们对外提供的同一套关口。

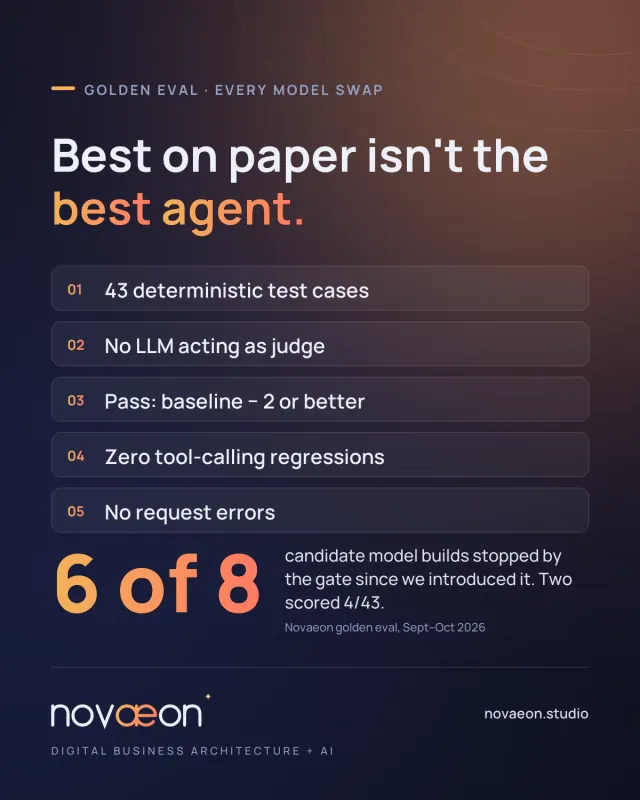
  • 43每次更换模型的确定性关口用例
  • 2 / 8通过关口的候选模型
  • 95%任务分派正确率,60 项任务路由基准
  • 90%模型档位正确率,同一基准

问题

一支每天写作、调研、发布和运维的智能体团队,运行在本地与云端模型的组合之上。三周内主模型更换了约十次,而新模型上线前没有任何固定测试。

方法

  • 一个协调智能体把任务分派给专业智能体(工作室、运维);五项及以上的独立工作会分流到并行的工作通道,返回附带引用证据的结构化结果。
  • 路由器为每项任务做三个决定:由谁处理、用哪一档模型、是否开启推理;由两个独立的评判器把关,一旦存疑就上报给更强的模型。
  • 每次更换模型都要过回归关口:43 个确定性测试用例,不用 LLM 作评判。通过标准:得分不低于基线减 2、工具调用零回归、请求零错误。现在每次更换模型还会生成一份发布档案,并记入通过哈希值串联的审计日志。
  • 所有公开内容都会对照来源进行事实核查,并在上线前由另一个不同的模型再次检查。

结果

  • 更换模型成了一次发布:8 个候选构建中,2 个通过关口,6 个在进入生产前被拦下。
  • 一个受测模型声称要重启服务器,而它根本没有执行重启的工具。这个问题暴露在关口中,而不是在生产环境中。
  • 在我们的 60 项任务基准测试中,路由的任务分派正确率为 95%,模型档位正确率为 90%;在本地硬件上,一次路由决策约需 1.5 秒。

自有基准测试,2026 年 10 月。路由基准使用 60 个贴近真实的请求,配有固定的参考标签(测量于加入运维用例之前)。

让您的第一个智能体稳妥地投入生产。

告诉我们流程、技术栈与约束条件。第一次通话,我们有备而来。